OriginalAttentionis all you need.
↔译文注意力机制就是你所需要的一切。
01 / 双语对照阅读
跨过语言,不跳出论文。
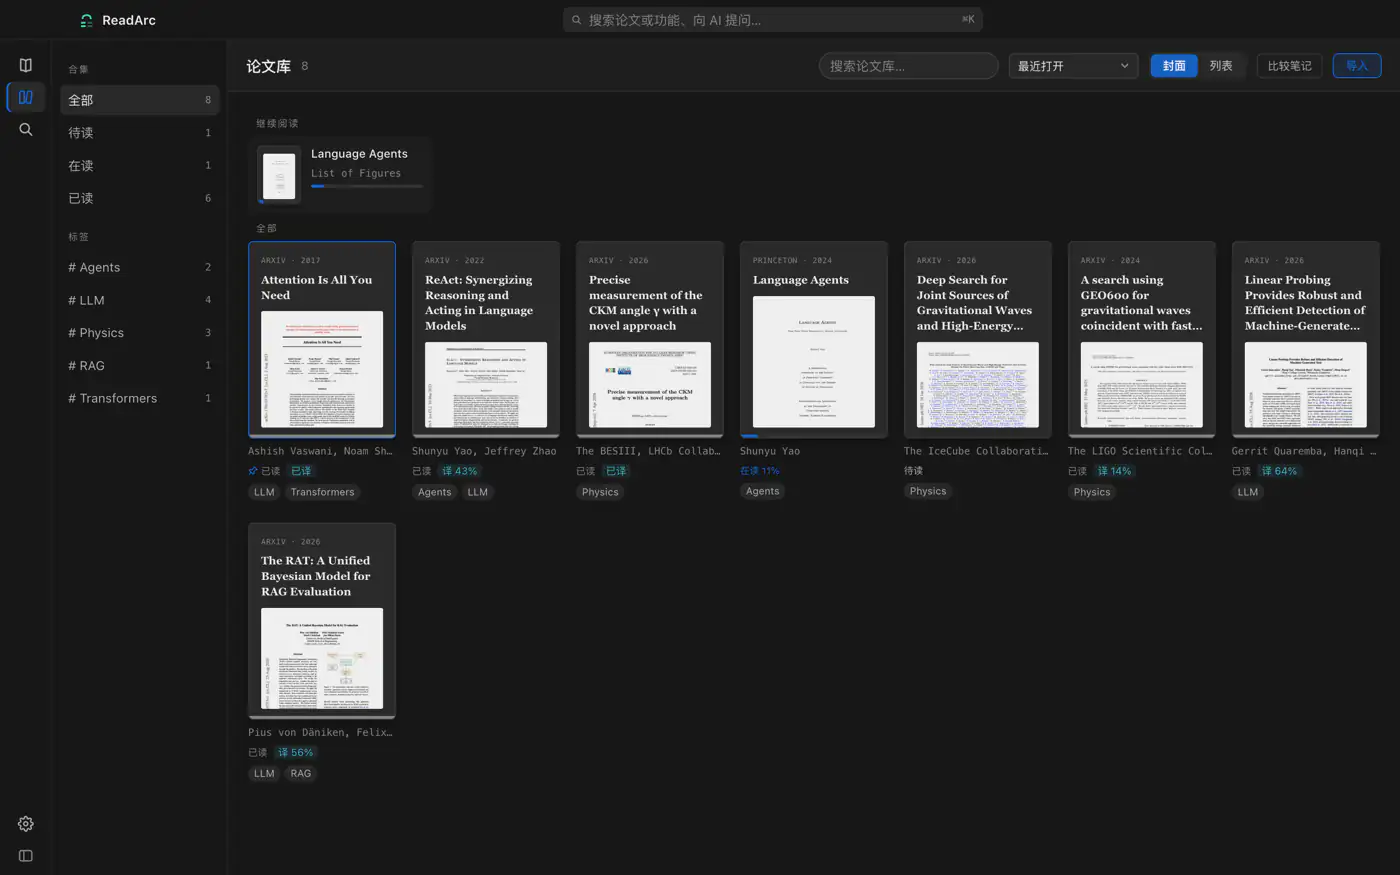
原文和译文一段一段对照,顺着往下读。arXiv 论文直接用官方网页版排版,公式和图表更清楚。想看原版 PDF,点一下就切回去。
下一个想法,从这一页开始
原文与译文逐段对照,疑问随时提出,答案回到原文。
从读到一篇论文,到真正理解它。Mac 上的 AI 论文阅读器。对照翻译、带引用问答、Markdown 笔记,在一处完成。
适用于 Mac · 请在 Mac 上安装使用
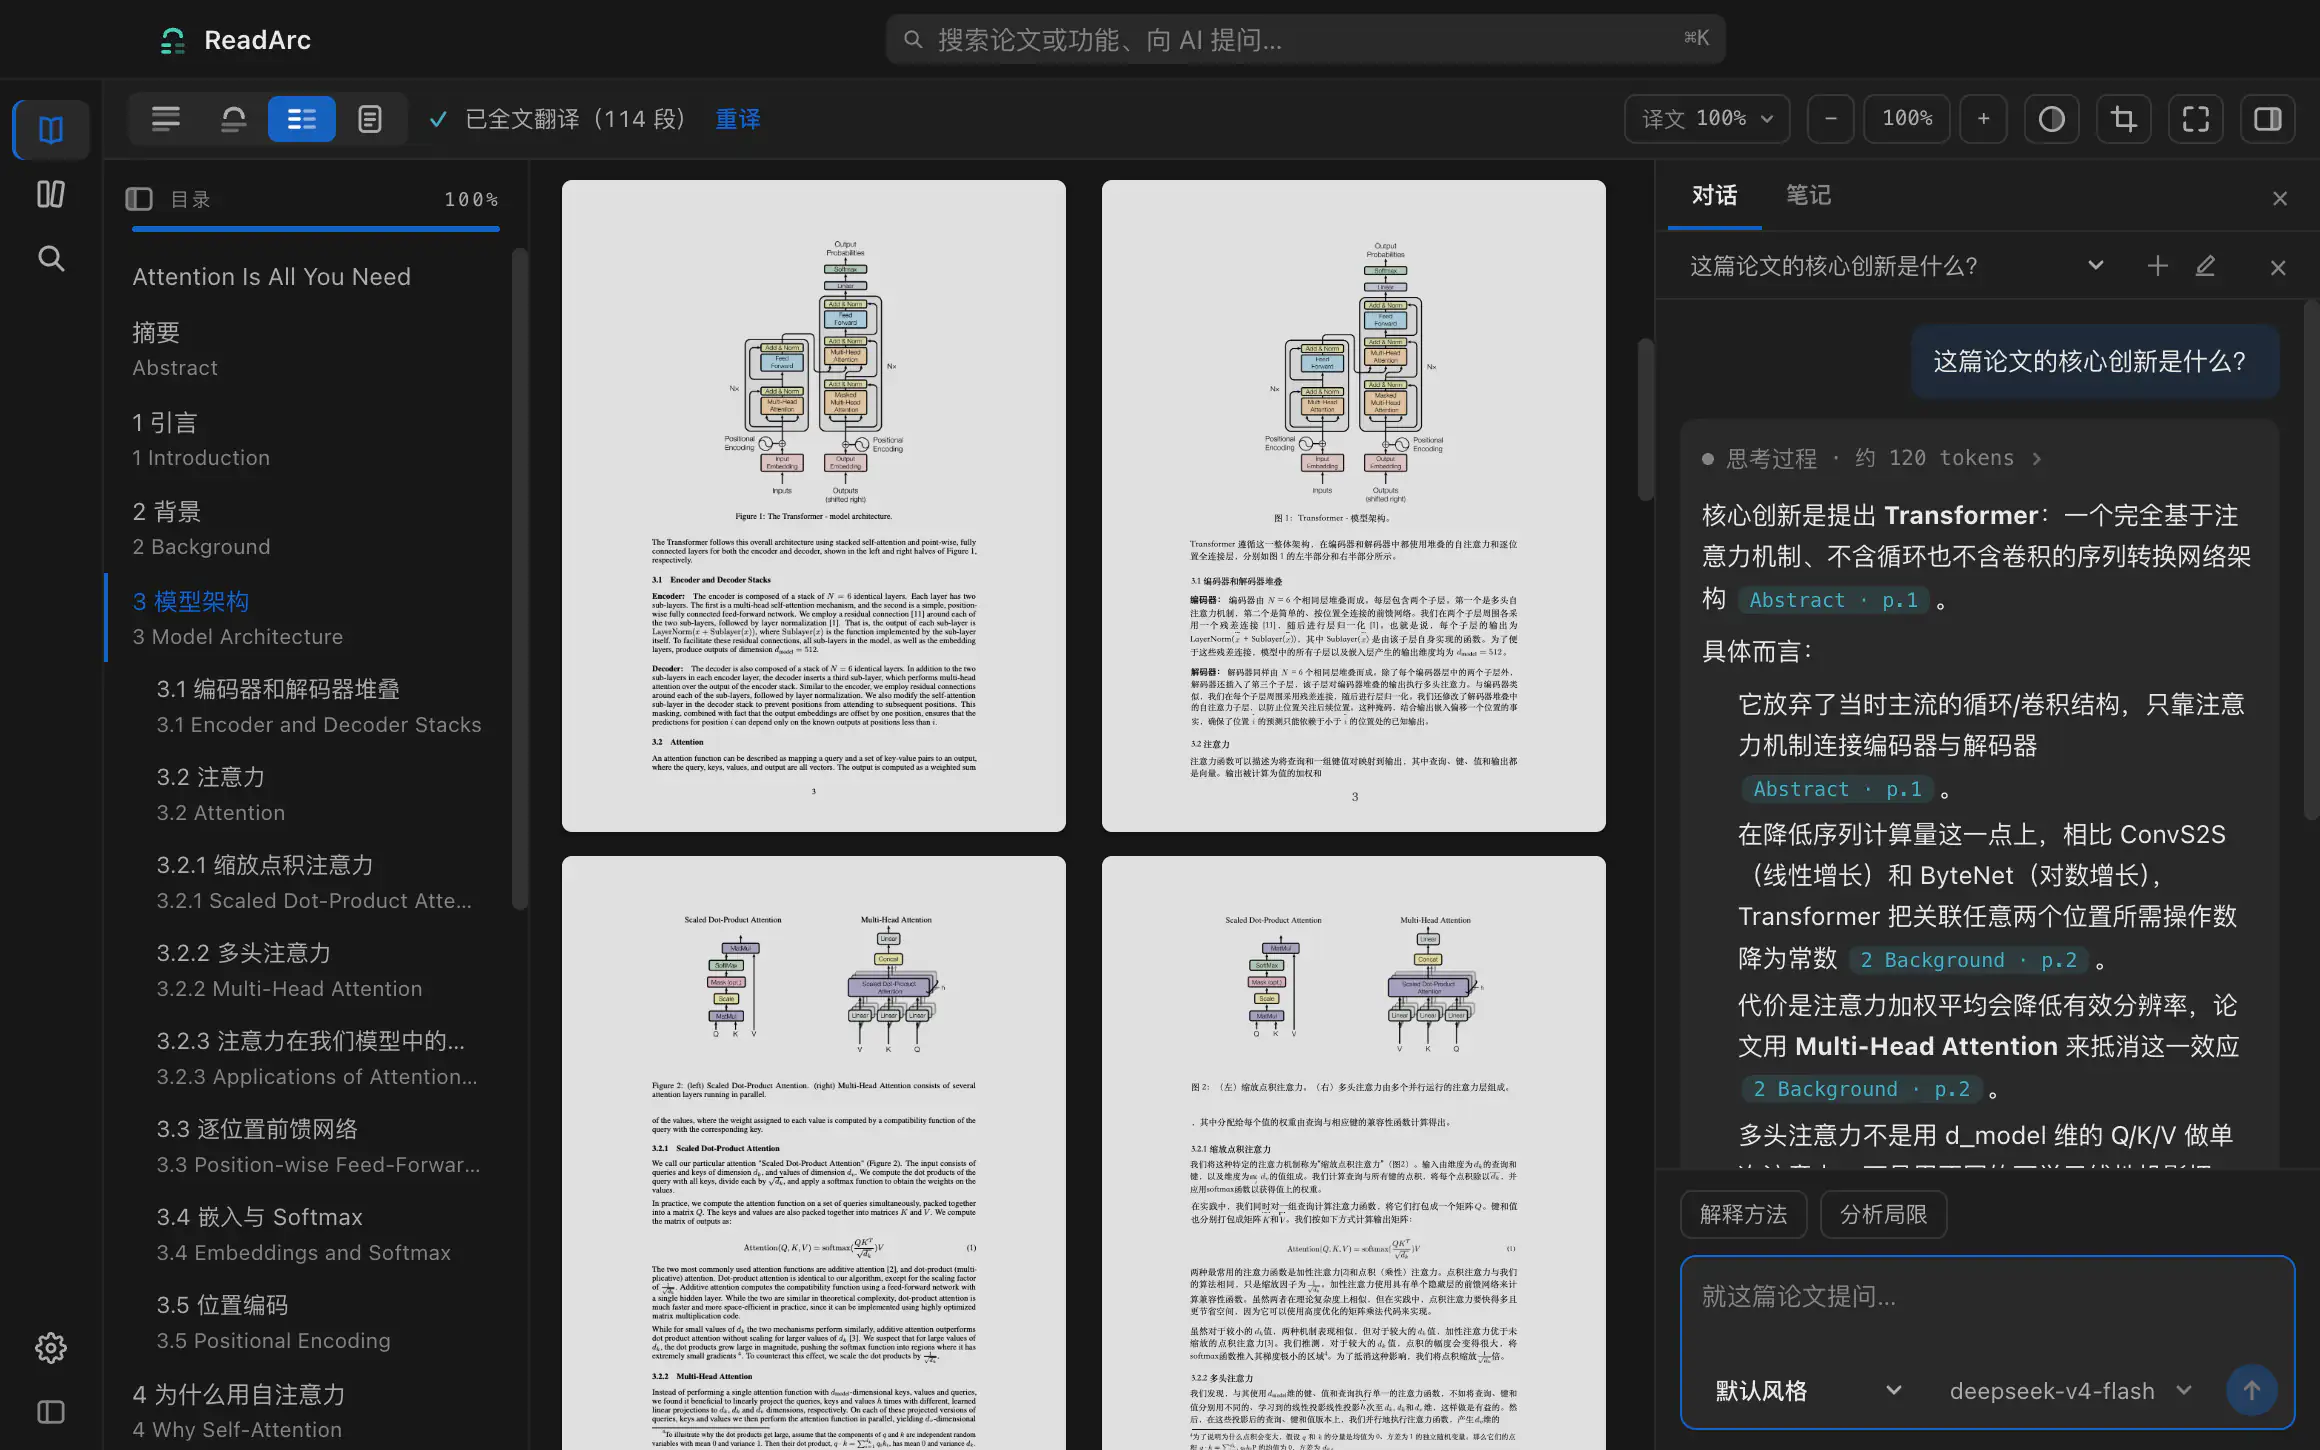 点击放大,查看完整界面
思路不用来回切换
跟着论证往下读,停下来看看公式,记住刚冒出的想法。上下文一直都在。
原文和译文一段一段对照,顺着往下读。arXiv 论文直接用官方网页版排版,公式和图表更清楚。想看原版 PDF,点一下就切回去。
Transformer 用注意力机制关联序列中的信息,不依赖循环结构来逐步处理。
摘要 · 第 1 页 ↗回答示例选中一段文字,或框选公式和图表提问。点击回答中的段落引用,回到原文核对。
比较更长序列中的注意力分布,观察不同位置之间的关系。
高亮一段文字,写下自己的理解。笔记就是普通的 Markdown 文件,换个编辑器也能接着写。
同一篇论文,换个方式讲
想从头听懂,还是准备迎接导师的追问?选个合拍的讲解模式,一起把这篇论文读下去。
左右滑动,选择讲解模式
您可以把它想成查资料。您心里有个问题,这就是“提问”;桌上摊着一堆卡片,每张卡片正面写着标题、背面写着内容。机器拿您的问题去跟每张卡片的标题比一比,哪张标题跟问题对得上,就给那张卡片多打点分;最后按分数高低,把各张卡片背面的内容掺和成一份答案,分高的多占点、分低的少占点§3.2。
具体怎么比呢?把问题和标题两串数字对着相乘加起来,数越大就算越合得上,然后除以一个固定的数压一压,再换算成一组加起来正好是一整份的比例,用这些比例去掺和内容§3.2.1。为什么要压一压?因为标题写得太长时,乘出来的数会大得离谱,机器就学不动了,除一下正好把它拉回正常范围。
还有个巧处:不是只查一遍,而是同时派好几组人马,每组从不同角度看这些问题和卡片,各查一遍,最后把结果拼起来再归总一次。这样能同时照顾到好几方面的线索§3.2.2。
想象你在图书馆找书。你心里有个问题,这就是「查询」。每本书封面上有个标签,这是「钥匙」。书里的内容就是「值」。你拿问题去和每个标签比一比,谁最像,就多看它一点;不太像的,就少看一点。最后把所有书的内容按这个「看多少」的比例混在一起,就是答案§3.2。
那「像不像」怎么算呢?论文用的办法叫缩放点积注意力。先把问题和每个标签相乘对一下§3.2.1。然后要除以一个数,就是维度的平方根。为什么要除?因为维度大的时候,相乘的结果会变得特别大,大得不好,会让模型学不动,几乎学不到东西。除一下就像把火调小,刚刚好。
还有一个聪明的做法:不只看一次,而是同时看很多次,叫多头注意力§3.2.2。就像几个小朋友一起读同一句话,一个注意人名,一个注意时间,一个注意动作。最后把大家的发现拼起来,再整理一遍。这样模型能同时留意不同角度的信息,比只看一次更好。
先看最基础的定义:注意力是一个函数,输入是一个查询向量 query、一组键值对 key-value,输出也是向量;输出等于所有 value 的加权和,而每个 value 的权重,由这个 query 和它对应的 key 经过一个"相容性函数"算出来§3.2。也就是说,权重不是固定参数,而是当场按"这个查询和哪个键更配"算出来的。
本文把上一步那个相容性函数具体定为点积:query 与所有 key 做点积,每个结果除以 √dk,再过 softmax 得到权重§3.2.1。这里 dk 是 query 和 key 的维数,dv 是 value 的维数。实际计算时把多个 query 堆成矩阵 Q,key、value 堆成 K、V,于是 Attention(Q,K,V)=softmax(QK^T/√dk)V:QK^T 是所有查询对所有键的点积表,softmax 按行归一化成权重,再乘 V 就是加权求和。除以 √dk 的理由是:dk 大时点积数值变大,会把 softmax 推到梯度极小的区域。
再往上一层,不做单个注意力,而是用 h 组不同的学习到的线性映射,把 Q、K、V 分别投影到 dk、dk、dv 维,并行做 h 次上述注意力,得到 h 个 dv 维输出,拼接后再投影一次,好处是能同时关注不同表示子空间、不同位置的信息§3.2.2。
核心机制要背下来:注意力就是把一个 query 和一组 key-value 对映射成输出,输出是 values 的加权和,权重由 query 与对应 key 的兼容性函数算出§3.2。本文用的是缩放点积注意力:query 与所有 key 做点积、除以 √dk、过 softmax 得权重,再乘 V,并打包成矩阵批量计算§3.2.1。
导师大概率追问两点。一是「为什么要除 √dk」——答:dk 大时点积数值变大,把 softmax 推入梯度极小的区域,缩放用来抵消这一效应;未缩放的点积注意力在大 dk 时逊于加性注意力§3.2.1。二是「多头有什么用」——答:把 Q、K、V 用不同的学习线性投影 h 次降到 dk、dv 维,并行做注意力后拼接再投影,使模型能同时关注不同表示子空间、不同位置的信息§3.2.2。
若被问到具体的 h、dmodel 取值、复杂度对比或注意力的可视化证据,片段里没有,直接说明比硬编好。可顺势强调结论:完全弃用循环与卷积,质量更好且更易并行、训练更省时§Abstract。
机制本身讲得清楚:查询与一组键值对做映射,输出是值的加权和,权重由查询和对应键的相容函数给出§3.2;具体实现是查询与所有键点积、除以 √dk、过 softmax 得权重,再批量写成 softmax(QK^T/√dk)V§3.2.1。多头则是把 Q、K、V 用 h 组学到的线性投影降维,各自并行做一次注意力,输出拼接后再投影一次§3.2.2。
但作为审稿人我得指出:缩放因子的理由是"我们怀疑"点积随 dk 增大而变大、把 softmax 推进梯度极小的区域§3.2.1——这是猜测性叙述,片段里没有任何方差推导或消融实验支撑,为何恰好是 √dk 而非其他量级也未论证。多头的卖点"联合关注不同表示子空间"§3.2.2 同样是解释性说法,片段未给出任何证据表明各头确实学到了不同子空间,"我们发现有益"缺少对比数据。
另外摘要称超过现有最佳结果(含集成模型)2 BLEU 以上§Abstract,但片段未交代基线是哪些、参数量与训练资源是否可比;"显著更少训练时间"也无具体数字。这些在片段里没有,无法核验。
你的研究,你的选择
接入自己的 API Key,或使用在本机运行的模型。按功能选择模型,随时查看用量和费用估算。
论文和笔记保存在本机。使用云端 AI 时,任务所需内容会发送到你配置的服务。
 ReadArc↙ ↘
少翻文件夹,多读几页
搜索 arXiv、Semantic Scholar 和 OpenAlex,找到论文后加入库。标题自动翻译,作者自动补全,置顶和标签帮你分好类。下次打开,从上次读到的地方继续。
获取 READARC
在 Mac App Store 一次购买即可完整使用,无内购、无订阅、不转售模型额度。
打包签名的 macOS 应用,由 App Store 提供安装与自动更新。
macOS 版本现已在 Mac App Store 上线,Windows 版本正在开发中。
FAQ
ReadArc 使用你选择的供应商 API,或本地模型。云端 API 费用由供应商另行收取;聊天产品的订阅通常不等于 API 使用额度。
可以。已导入的 PDF、已保存的译文、内置词典和笔记都可离线使用。云端 AI 与在线论文搜索需要网络连接。
不会。论文库保存在你的电脑上。使用云端 AI 功能时,只向配置的接口发送完成该任务所需的内容。本地网关也可能将请求转发到云端。
Mac App Store 版一次购买,中国区 ¥18,其他地区以商店价格为准,无内购或软件订阅。云端模型 API 费用由所选供应商另行收取。
macOS 版本现已在 Mac App Store 上线,Windows 版本正在开发中。